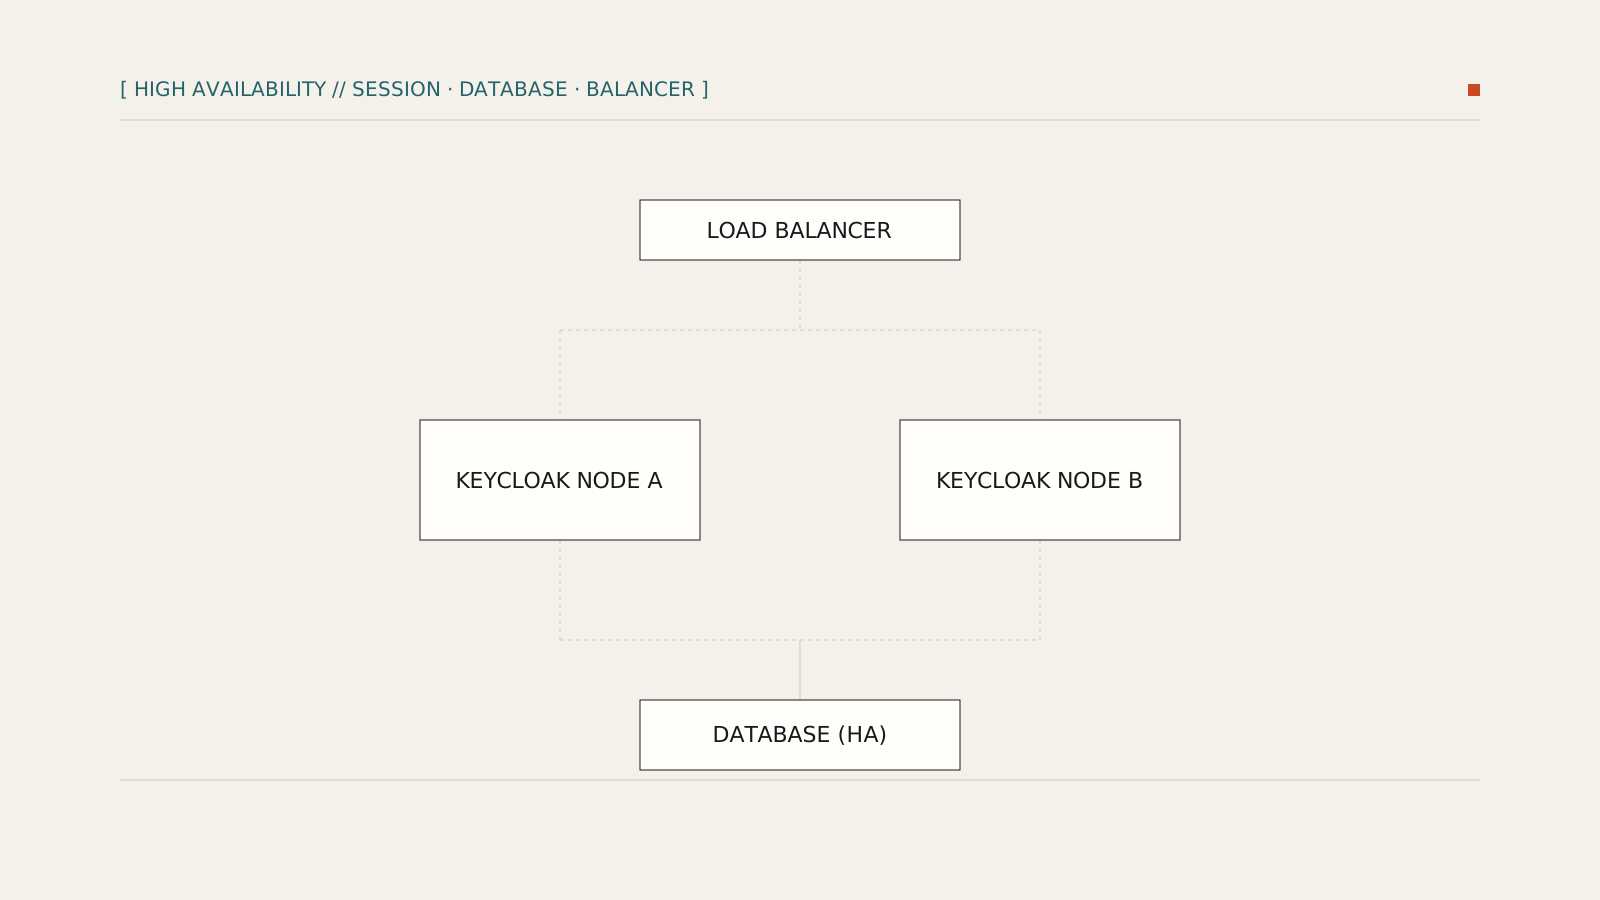
Hochverfügbarkeit ist bei Keycloak keine Konfigurationsoption, sondern eine Architekturentscheidung. Die eigentliche Frage lautet nicht „wie viele Knoten“, sondern: Was passiert mit bestehenden Sitzungen, wenn ein Knoten ausfällt?
Die Frage vor der Konfiguration
Ein zweiter Keycloak-Knoten erhöht die Verfügbarkeit nur dann, wenn geklärt ist, was er im Ausfall übernimmt. Ohne diese Klärung entsteht ein System, das im Normalbetrieb redundant aussieht und im Ernstfall alle Benutzer abmeldet.
Drei Entscheidungen stehen deshalb vor jeder Konfigurationsdatei.
Sitzungshaltung
Keycloak hält Sitzungsinformationen im Speicher. Ob diese zwischen den Knoten repliziert werden, entscheidet über das Verhalten im Ausfall:
- Ohne Replikation verlieren Benutzer beim Knotenausfall ihre Sitzung und müssen sich neu anmelden. Das ist vertretbar – aber es muss bekannt sein.
- Mit Replikation überstehen Sitzungen den Ausfall. Der Preis ist ein zusätzlicher verteilter Zustand, der selbst ausfallen kann.
Entscheidung
Beide Varianten sind legitim. Nicht legitim ist, die Frage offenzulassen und im Vorfall festzustellen, welche Variante man gebaut hat.
Die Datenbank ist der eigentliche Single Point of Failure
Realms, Clients, Benutzer und Rollen liegen in der Datenbank. Ein Keycloak-Cluster vor einer nicht hochverfügbaren Datenbank ist ein Trugschluss: Die Anwendungsebene ist redundant, die darunter liegende nicht.
Engineering Note
Wer Hochverfügbarkeit für Keycloak plant, plant zuerst Hochverfügbarkeit für die Datenbank. Alles andere ist ein Reihenfolgefehler.
Loadbalancer und Sticky Sessions
Sticky Sessions sind verführerisch, weil sie Replikationsprobleme unsichtbar machen. Genau das ist das Problem: Der Fehler verschwindet nicht, er wird nur erst im Ausfall sichtbar – also dann, wenn ohnehin gerade etwas anderes kaputt ist.
Ein Health-Check sollte den tatsächlichen Bereitschaftszustand prüfen und nicht nur, ob der Port antwortet:
curl --fail --silent --max-time 3 \
  http://127.0.0.1:9000/health/ready \
  || exit 1
Betriebsgrenzen benennen
Eine Architektur ist erst dann belastbar, wenn dokumentiert ist, wer welchen Teil verantwortet – und zwar vor dem Vorfall:
| Bereich | Verantwortung |
|---|---|
| Keycloak-Konfiguration | Anwendung |
| Datenbankbetrieb | Plattform |
| TLS-Terminierung | Loadbalancer |
| Verzeichnisdienst | Organisation |
Was das für ein Projekt bedeutet
Die Reihenfolge lautet: Ausfallverhalten festlegen, Datenbank absichern, dann erst Knoten hinzufügen. Wird sie umgedreht, entsteht ein Cluster, dessen Verhalten niemand vorhersagen kann.
Aus der Praxis
Ein geplanter Knotenausfall im Testbetrieb beantwortet in zehn Minuten, was sonst monatelang eine Annahme bleibt.
Wie diese Fragen in einem konkreten Auftrag zusammenspielen, beschreibt das Arbeitsfeld Identity & Access Management.